Gasta menos tokens sin perder calidad
Activa los ajustes que recortan lo que Pando envía al modelo y mira cuánto has ahorrado.
Un token es la unidad por la que cobran los modelos de IA, más o menos un «contador de palabras» de todo lo que se envía y se recibe. Cuanto menos relleno mande Pando, más rápida y barata sale cada respuesta. Casi todo el ahorro ya viene activado; esta guía enseña dónde está, qué extras merece la pena probar y cómo leer el contador. La app de escritorio es idéntica a la Web UI que se muestra aquí. Las capturas están en inglés; los nombres en negrita son los de la interfaz en español.
Abre Optimización de tokens
Ve a Configuración > Optimización de tokens.
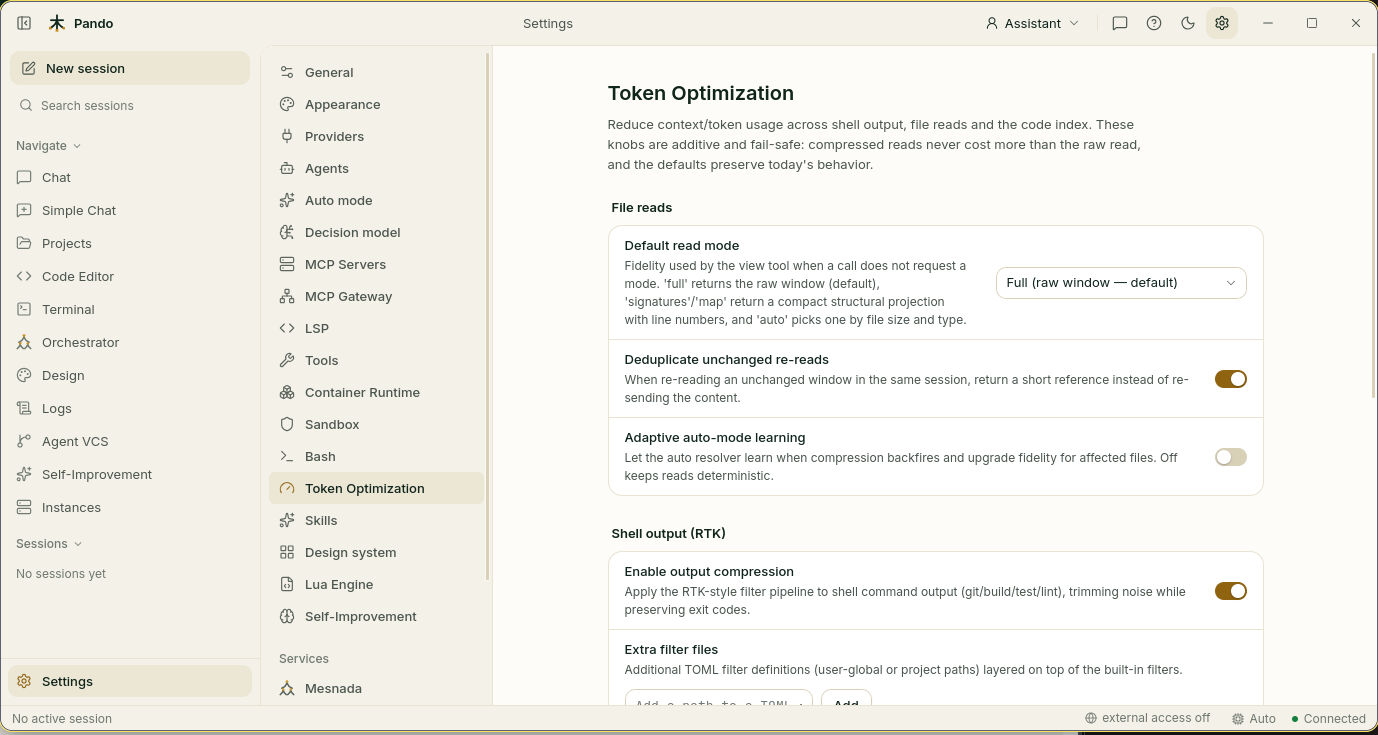
Todo lo que hay en esta página se puede probar sin miedo: si un atajo fuera a salir más caro que el camino largo, Pando toma el camino largo por su cuenta.
Elige cuánto de cada fichero ve el modelo
Modo de lectura por defecto decide qué le enseña Pando al modelo cuando abre un fichero:
| Opción | Qué recibe el modelo | Úsala cuando |
|---|---|---|
| Completo (por defecto) | El fichero tal cual | Ficheros pequeños, o no quieres que se oculte nada |
| Auto | Pando elige según tamaño y tipo | Trabajas con ficheros grandes y quieres ahorrar sin pensarlo |
| Firmas | Solo los nombres de funciones y clases, como un índice | Necesitas la forma de un fichero grande |
| Mapa | Solo lo que el fichero importa y sus elementos principales | Un vistazo rápido a cómo está organizado |
Empieza con Completo. Pasa a Auto cuando los ficheros sean grandes.
Deja activado Deduplicar relecturas sin cambios: cuando el modelo pide un trozo que ya tiene, Pando contesta «igual que antes» en vez de mandarlo otra vez.
Aprendizaje del modo auto solo importa con Auto. Pando ya se da cuenta de cuándo un resumen no bastó y la próxima vez manda el fichero entero. Este interruptor añade adivinar por adelantado a partir de la experiencia. Déjalo apagado salvo que Auto resuma una y otra vez ficheros que necesitan todo el detalle.
Baja el volumen a los comandos ruidosos
En Salida de shell (RTK), deja encendido Activar compresión de salida. Los tests, las compilaciones y las instalaciones imprimen páginas de texto; Pando se queda con los errores y el resultado y tira el confeti.
Ficheros de filtro adicionales sirve para añadir tus propias reglas de recorte para herramientas especiales. Casi todo el mundo lo deja vacío.
Guarda en el cajón las herramientas que casi no se usan
Ve a Configuración > General y baja hasta Descubrimiento de herramientas.
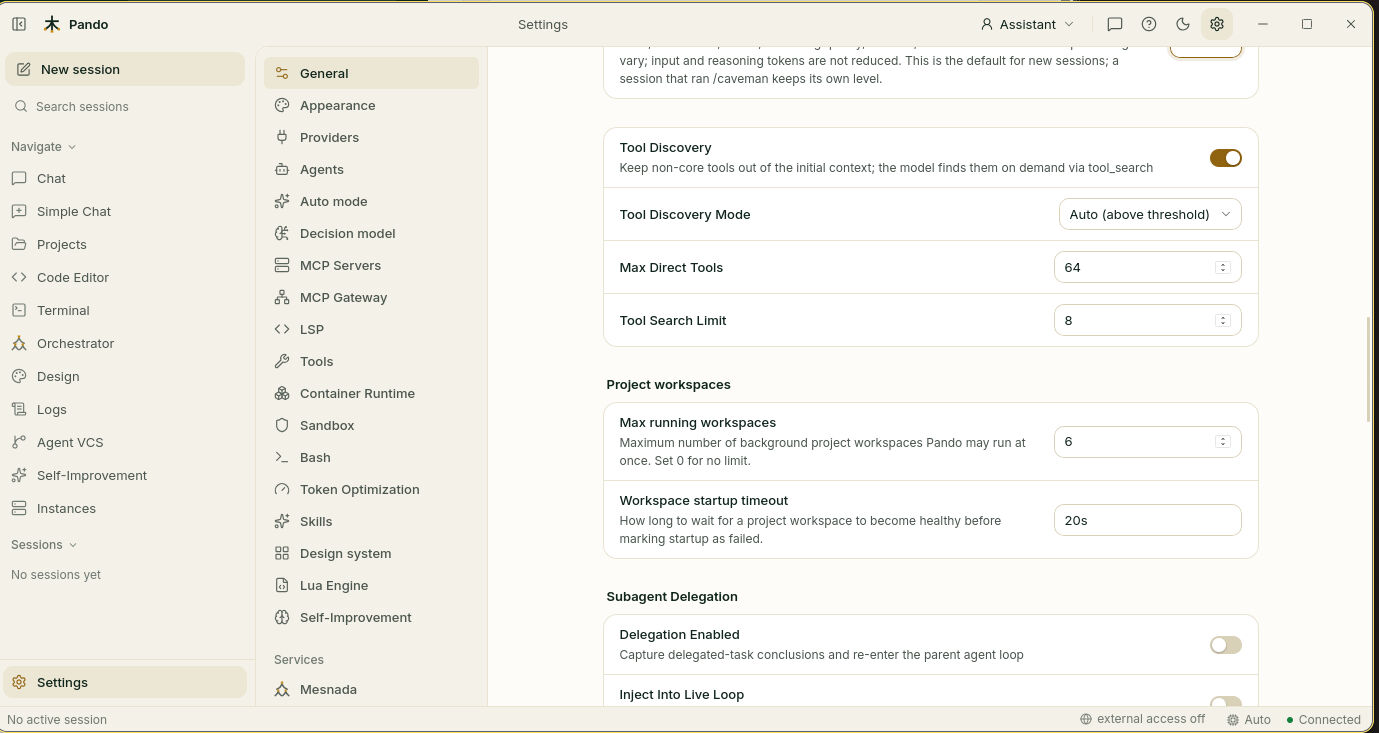
Cada herramienta que conectas trae una descripción que el modelo lee en cada mensaje. Con Descubrimiento de herramientas activado, solo las de uso diario se quedan en el banco de trabajo; el resto espera en un cajón y el modelo las busca cuando necesita una.
- Modo de descubrimiento: Automático (por encima del umbral) empieza a usar el cajón cuando tienes muchas herramientas. Siempre lo usa desde la primera. Desactivado lo enseña todo.
- Máx. herramientas directas: cuántas herramientas son «muchas» (64 por defecto).
- Límite de búsqueda de herramientas: cuántos resultados recibe el modelo en cada búsqueda (8 por defecto).
Enciende los ahorradores pequeños
Arriba del todo en Configuración > General:
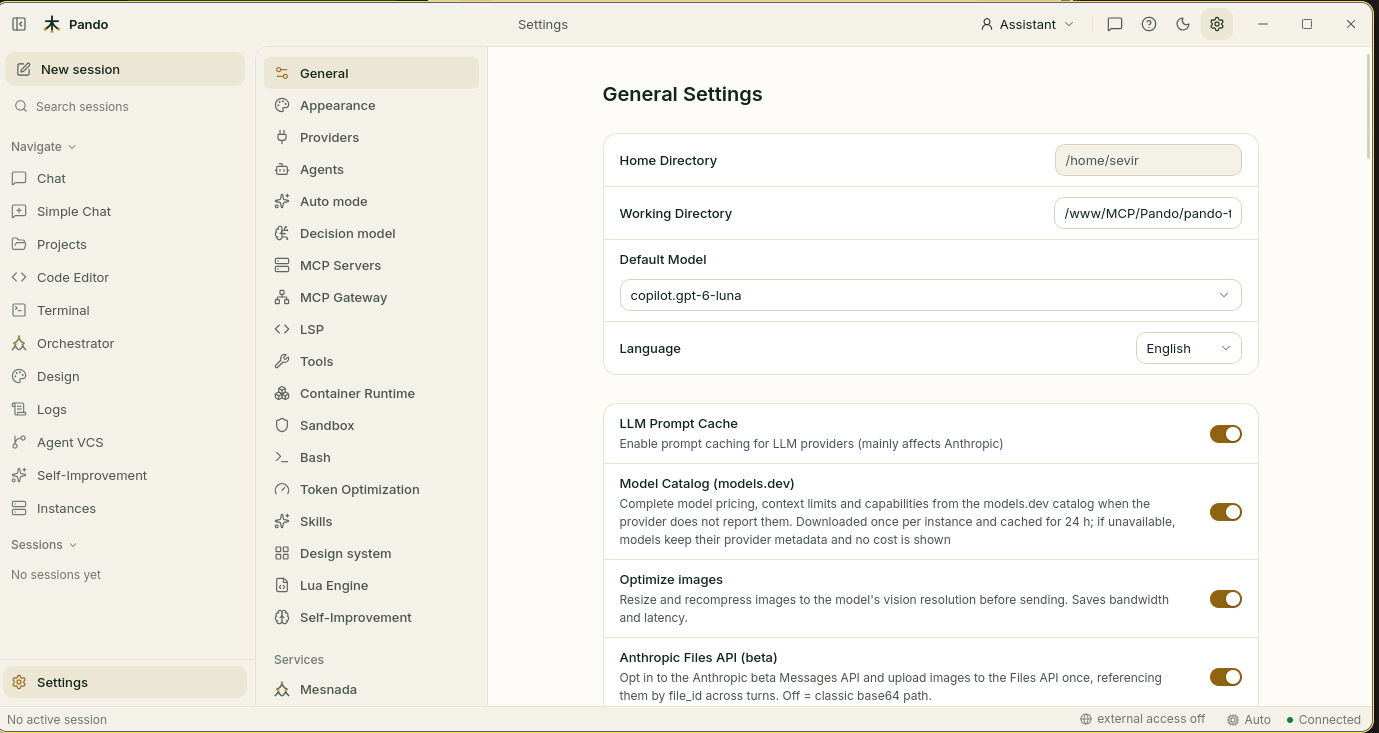
- Caché de prompts LLM: deja que el proveedor recuerde el principio de la conversación que no cambia, para que no lo pagues entero cada vez.
- Optimize images: encoge capturas e imágenes al tamaño que el modelo realmente mira antes de enviarlas.
- Catálogo de modelos (models.dev): rellena precios y límites cuando tu proveedor no los da, para que el coste que ves sea real.
Más abajo, Brevedad de salida (Caveman) hace que Pando conteste con menos palabras. Mira la funcionalidad Caveman.
Activa los extras opcionales
De vuelta en Configuración > Optimización de tokens, en Grafo de código:
- Construir grafo de propiedades del código (encendido) apunta qué ficheros usan a cuáles, para que Pando pueda responder «¿a qué afecta este cambio?».
- Sugerencia de ficheros relacionados (apagado) añade una lista corta de ficheros conectados a lo que lee el modelo. Cuesta unos pocos tokens y puede ahorrar una búsqueda.
Pulsa Guardar.
Comprueba que funciona
Trabaja un rato, vuelve a Configuración > Optimización de tokens y mira Ahorros registrados: tokens ahorrados, el porcentaje y de dónde han salido. Deja activado Registrar el libro de ahorro de tokens para que el contador cuente.
Si algo falla
| Qué ves | Qué hacer |
|---|---|
| Al modelo se le escapan detalles de un fichero | Devuelve Modo de lectura por defecto a Completo |
| «Aún no hay ahorros registrados» | Normal en un proyecto nuevo. Las lecturas y los comandos lo van rellenando |
| El modelo no encuentra una herramienta que conectaste | Pon Modo de descubrimiento en Desactivado para probar, o sube Máx. herramientas directas |
| La salida de un comando parece cortada | Apaga Activar compresión de salida en esa sesión y compara |
¿Prefieres la terminal?
pando gain                 # ahorro hasta ahora
pando gain --days 30       # últimos 30 días
pando gain --price 3       # dinero estimado a 3 $ por millón de tokens
pando gain --json          # para scripts
PANDO_READ_MODE_DEFAULT=auto pando   # una ejecución con lectura Auto
Los nombres exactos de las opciones están en la referencia de optimización de tokens. La idea del cajón de herramientas se explica en Descubrimiento de herramientas.