Dale reflejos rápidos a Pando con un modelo de decisión
Instala el modelo diminuto que toma las pequeñas decisiones de Pando, pruébalo y enchúfalo al modo automático, a las personas y al filtro de contexto.
Al terminar esta guía Pando tendrá un modelo diminuto y rápido para sus pequeñas decisiones: qué modelo responde, qué persona encaja, qué notas merece la pena traer. Lo configuras una vez y lo usan tres funciones. Necesitas Ollama 0.35 o posterior en tu equipo. Para entender para qué sirve, lee Modelo de decisión.
Las pantallas son de la Web UI; la app de escritorio es igual.
Abre la página del modelo de decisión
Abre Configuración > Modelo de decisión.
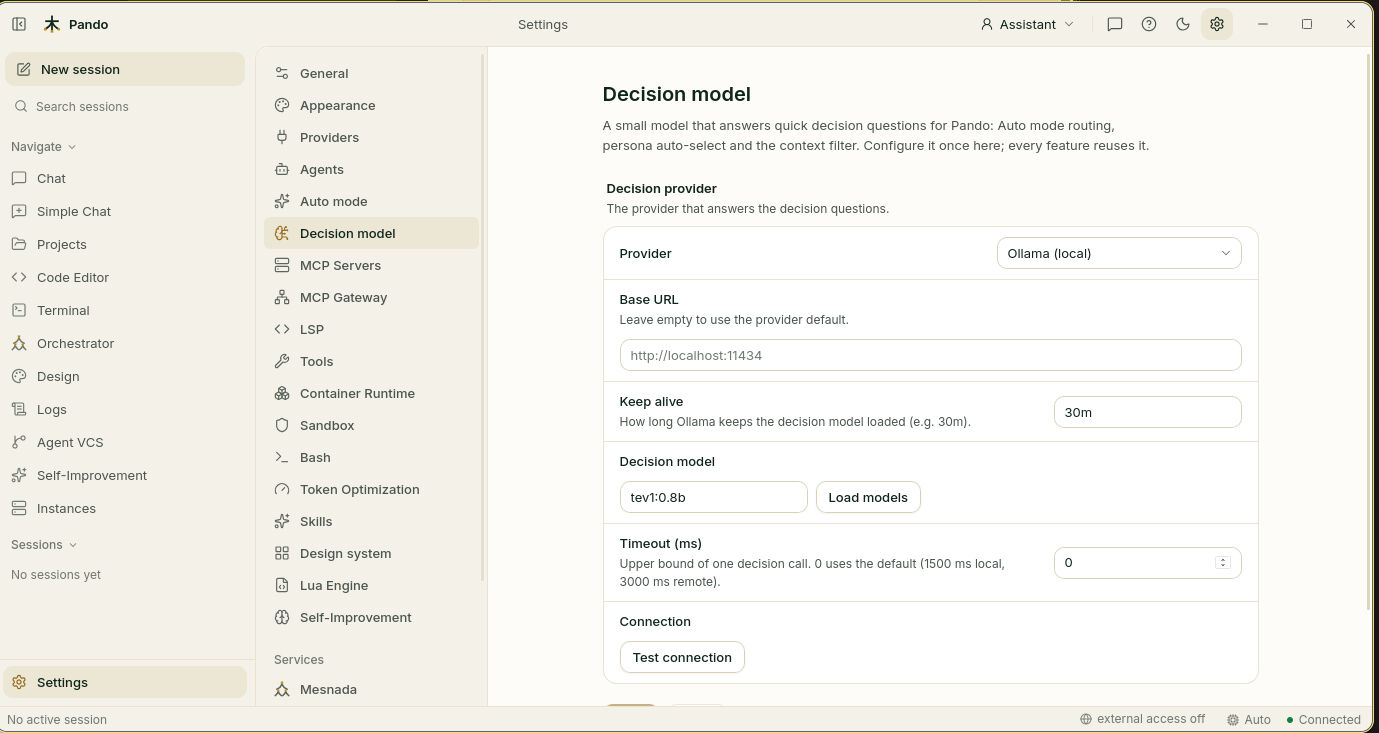
En Proveedor deja Ollama (local). Deja URL base vacía salvo que tu Ollama viva en un sitio poco habitual.
Consigue el modelo
En Modelo de decisión, pulsa Cargar modelos.
- Si la lista trae entradas, elige tev1:0.8b.
- Si está vacía, Pando muestra Modelos de decisión sugeridos con un botón Descargar junto a cada uno. Pulsa Descargar en tev1:0.8b y espera a que baje (unos 800 MB). Después pulsa Cargar modelos otra vez y elígelo.
Un modelo de chat pequeño cualquiera no sirve: la lista enseña los modelos hechos para este trabajo.
Ajusta los dos relojes
- Mantener cargado es cuánto tiempo sigue despierto el modelo entre pregunta y pregunta. Con
30mresponde al instante mientras trabajas y se duerme cuando paras. - Tiempo de espera (ms) es cuánto espera Pando una decisión antes de seguir sin ella.
0usa un valor sensato: segundo y medio para un modelo local.
Pruébalo
Pulsa Probar conexión. Pando hace un chequeo corto y muestra una línea por cada cosa:
| Línea | Qué significa |
|---|---|
| Accesible | Ollama responde |
| Autorizado | La clave, si la hay, es válida |
| Versión ≥ 0.35 | Tu Ollama es lo bastante nuevo |
| Modelo presente | El modelo elegido está descargado |
| Modelo apto para decisiones | Es el tipo de modelo adecuado |
| Latencia | Cuánto tarda una decisión |
Todas las líneas deben salir en verde. Pulsa Guardar.
Úsalo para elegir el modelo
Es el uso principal: Pando lee cada mensaje y lo manda al modelo que elegiste para ese tipo de trabajo. Tiene su propia guía: Deja que Pando elija el modelo adecuado para cada mensaje.
Úsalo para elegir la persona
Una persona es un sombrero que se pone Pando: asistente, ingeniero de software, QA. Con Auto elegido en la lista de personas de arriba a la derecha, Pando elige el sombrero en cada petición. Normalmente esa elección la hace un modelo de chat; el modelo de decisión la hace más rápido y gratis.
Abre Configuración > Agentes y despliega Persona Selector.
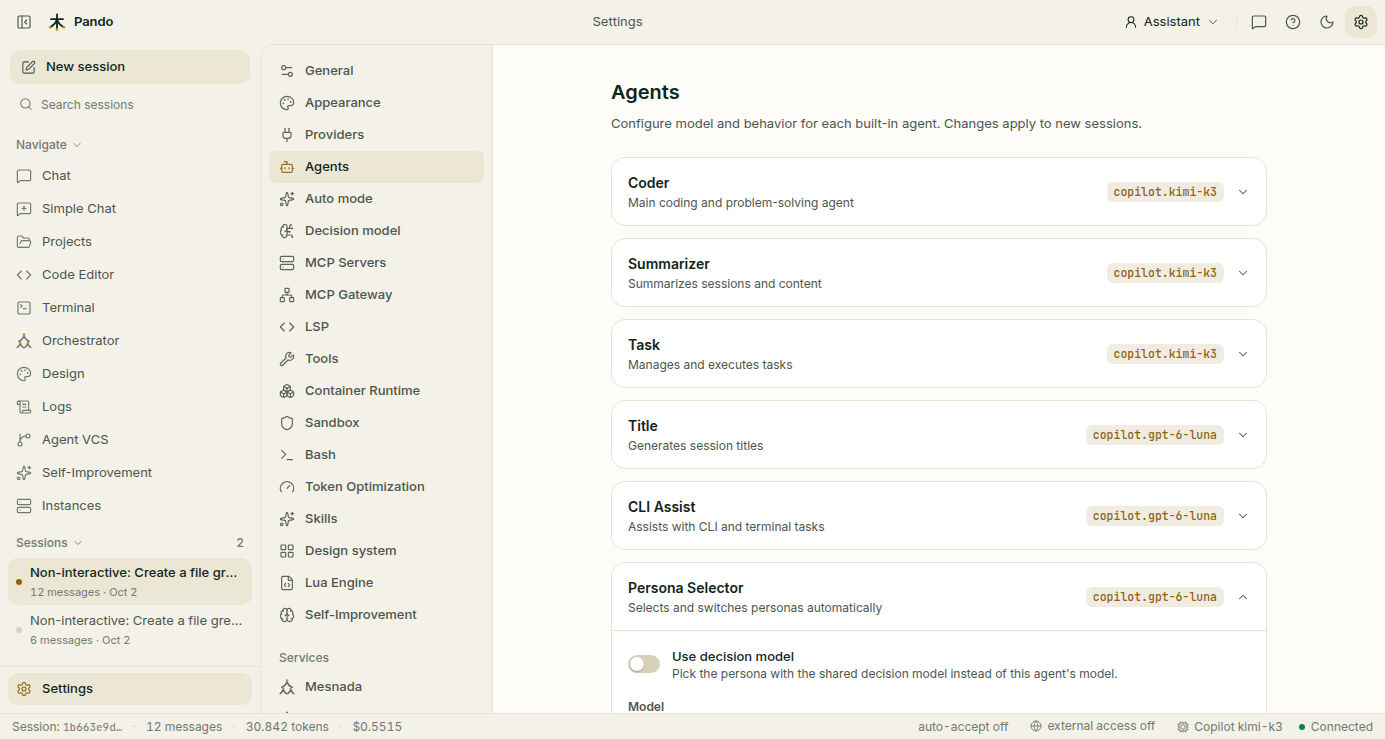
Activa Use decision model. El campo Model de debajo pasa a llamarse Fallback model: el que decide cuando el modelo de decisión no está disponible. Pulsa Save.
Úsalo para filtrar lo que trae Pando
Si usas Remembrances, Pando reúne notas y código antes de responder. El modelo de decisión puede mirar cada hallazgo y descartar los que no tienen nada que ver con tu pregunta, como quien repasa la mochila antes de salir y saca lo que no hace falta.
Abre Configuración > Remembrances y baja hasta Filtro de relevancia con el modelo de decisión.
- Filtrar el contexto recuperado con el modelo de decisión revisa las notas, el código y los eventos pasados.
- Filtrar las memorias inyectadas con el modelo de decisión revisa los datos cortos de la memoria.
- Umbral de relevancia es lo estricta que es la revisión, de 0 a 1. El valor inicial,
0.6, es bueno. Más alto significa que pasan menos hallazgos. - Permitir proveedores de decisión alojados está desactivado: solo un modelo de tu equipo puede leer tus notas. Déjalo así salvo que sepas que quieres otra cosa.
Pulsa Save.
Comprueba que funciona
- En Configuración > Modelo de decisión, Probar conexión sale todo en verde.
- En Configuración > Auto mode, el cuadro Modelo de decisión dice Operativo.
- En Configuración > Agentes, Persona Selector muestra el modelo de decisión en uso.
Si algo falla
| Qué ves | Qué hacer |
|---|---|
| Accesible en rojo | Ollama no está en marcha. Arráncalo y prueba otra vez |
| Versión ≥ 0.35 en rojo | Actualiza Ollama |
| Modelo presente en rojo | Elige un modelo en Modelo de decisión, o descárgalo antes |
| La lista de modelos está vacía y no hay botón Descargar | Ejecuta ollama pull tev1:0.8b en una terminal y pulsa Cargar modelos |
| La primera decisión del día va lenta | El modelo estaba dormido. Sube Mantener cargado |
| Las decisiones caducan a menudo | Sube Tiempo de espera (ms), por ejemplo a 3000 |
| Un aviso dice que tus prompts salen de tu equipo | Elegiste un proveedor alojado. Vuelve a Ollama (local) si no era tu intención |
¿Prefieres la terminal?
ollama pull tev1:0.8b
pando doctor # checks that the decision model answers[DecisionModel.Router]
Provider = 'ollama'
Model = 'tev1:0.8b'
KeepAlive = '30m'Los proveedores alojados (TypeSafe Jev o una Pasarela personalizada compatible con Jev) y todas las claves están en la referencia del modo automático y del modelo de decisión.