Elige un modelo que sepa leer código
Dale a la búsqueda de código de Pando un modelo ayudante entrenado con código, para que encuentre funciones por lo que hacen en cualquiera de tus lenguajes.
Al terminar esta guía Pando buscará en tu código con un modelo ayudante entrenado con código, en lugar de uno entrenado con texto corriente. Son diez minutos y una descarga de entre 90 y 170 MB. Necesitas Remembrances activado y Ollama en marcha. Por qué importa se explica en Búsqueda de código por significado.
Las pantallas son de la Web UI; la app de escritorio es igual.
Elige tu modelo
Tres buenas opciones, todas gratuitas y todas funcionando en tu equipo:
| Si… | Usa | Tamaño |
|---|---|---|
| quieres el más pequeño y rápido | CodeRankEmbed | 90 MB |
| escribes en muchos lenguajes (Rust, C#, shell, SQL, Lua…) | Jina Embeddings v2 Base Code | 170 MB |
| además quieres un solo modelo para notas en varios idiomas | Qwen3 Embedding 0.6B | 640 MB |
Si dudas, quédate con el segundo: conoce treinta lenguajes de programación y es casi tan rápido como el primero. La referencia tiene los detalles de cada uno, y los que no funcionan.
Descárgalo
Ollama puede traer modelos directamente de Hugging Face, la biblioteca pública donde se publican. Abre una terminal y ejecuta la línea del modelo elegido:
# CodeRankEmbed
ollama pull hf.co/brandtcormorant/CodeRankEmbed-Q4_K_M-GGUF:Q4_K_M

# Jina Embeddings v2 Base Code
ollama pull hf.co/ggml-org/jina-embeddings-v2-base-code-Q8_0-GGUF:Q8_0

# Qwen3 Embedding 0.6B
ollama pull qwen3-embedding:0.6b
Dile a Pando que lo use para el código
Abre Configuración > Remembrances y baja hasta Code embeddings.
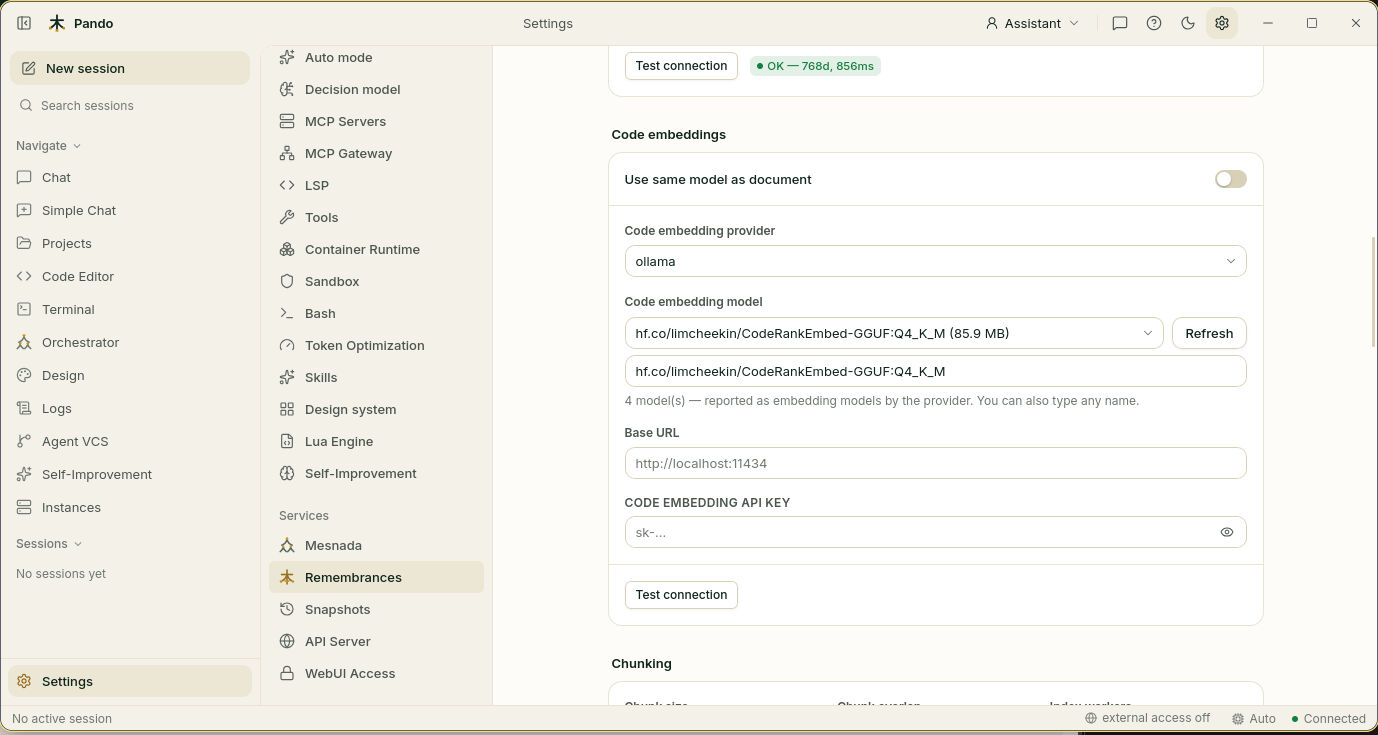
- Desactiva Use same model as document. Aparecen los campos de un segundo modelo.
- En Code embedding provider elige ollama.
- Pulsa Refresh y elige tu modelo en Code embedding model. Si no sale en la lista, pega su nombre completo en la casilla de debajo, tal cual lo escribiste después de
ollama pull. - Deja vacíos Base URL y la clave de API.
- Pulsa Test connection. Un OK verde con un número como
768dsignifica que el modelo responde. - Pulsa Save.
El modelo de tus notas, en Document embeddings, se queda como estaba.
Dibuja el mapa otra vez
Un bibliotecario nuevo no sabe leer las fichas del anterior, así que hay que volver a dibujar el mapa de tu código. Baja hasta Code indexing y pulsa Re-index all.
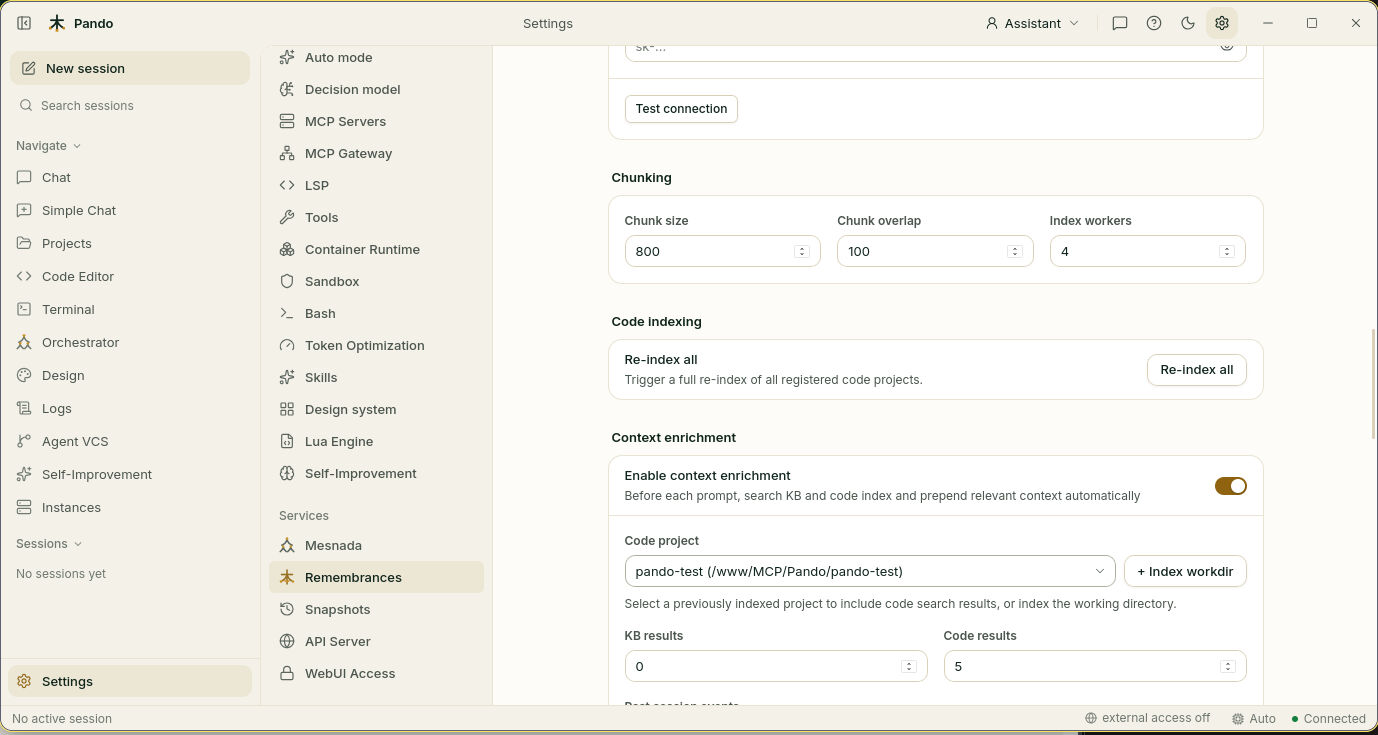
Pando recorre tu proyecto de nuevo en segundo plano. Puedes seguir trabajando; las búsquedas mejoran según avanza. Index workers, en Chunking, es cuántos ficheros lee a la vez: súbelo en un equipo potente, bájalo si el ventilador protesta.
Comprueba que funciona
Empieza una sesión nueva y pregunta por tu código sin usar las palabras que aparecen en él. Si tienes una función llamada ValidateToken, pregunta: «¿Dónde decidimos si un visitante puede pasar?». Pando debería ir a esa función a la primera.
Si algo falla
| Qué ves | Qué hacer |
|---|---|
ollama pull dice que no encuentra el modelo | La dirección tiene una errata, o el modelo se retiró. El que sugerían versiones anteriores de Pando, hf.co/limcheekin/CodeRankEmbed-GGUF, ya no está publicado: usa la línea de CodeRankEmbed de arriba |
| El asistente de configuración no pudo descargar el modelo de código | La misma causa. El campo Modelo de código del asistente se puede editar: pega uno de los nombres de arriba |
Test connection falla con un error 501 | Ese modelo no sabe generar embeddings en Ollama. Elige uno de la tabla |
| Test connection falla | Ollama no está en marcha, o el nombre tiene una errata. Pulsa Refresh |
| Las búsquedas empeoraron tras el cambio | Aún no has reindexado. Pulsa Re-index all y espera |
| La indexación va lenta | Elige un modelo más pequeño, o sube Index workers |
¿Prefieres la terminal?
[Remembrances]
UseSameModel          = false
CodeEmbeddingProvider = 'ollama'
CodeEmbeddingModel    = 'hf.co/ggml-org/jina-embeddings-v2-base-code-Q8_0-GGUF:Q8_0'
La comparativa de modelos y todas las claves están en Modelos de embeddings para código.