Modo automático de modelos
El modo automático deja que Pando elija el modelo para cada mensaje. Imagina al recepcionista de una clínica: le cuentas qué te pasa y te manda a la puerta adecuada, el especialista para algo serio y la enfermera para una tirita. Tú describes unos pocos tipos de trabajo y dices qué modelo se ocupa de cada uno. El trabajo difícil va a tu modelo más potente y las preguntas rápidas a uno barato o local.
Viene desactivado por defecto.
Qué hace por ti
- Dejas de cambiar de modelo a mano. Eliges Auto una vez y te olvidas.
- Gastas donde importa. El modelo caro solo se usa para el trabajo que lo necesita.
- Nunca te deja esperando. Si ninguna puerta encaja, o el recepcionista no está, el mensaje va a tu modelo habitual.
- Tiene plan B. Cada tipo de trabajo puede nombrar modelos de repuesto para cuando el primero está ocupado o caído.
Cómo se nota en el día a día
Eliges Auto en la lista de modelos y escribes como siempre. Con cada mensaje, un modelo de decisión muy pequeño y muy rápido lo lee, elige el tipo de trabajo que mejor encaja y Pando responde con el modelo que asignaste. Una línea en el chat te dice cuál ha elegido:
Auto: implementation → anthropic.claude-sonnet-4 (p=0.93, 38 ms via ollama/tev1:0.8b)La elección se hace una vez por mensaje. Mientras Pando da sus pasos para ese mensaje, el modelo no cambia.
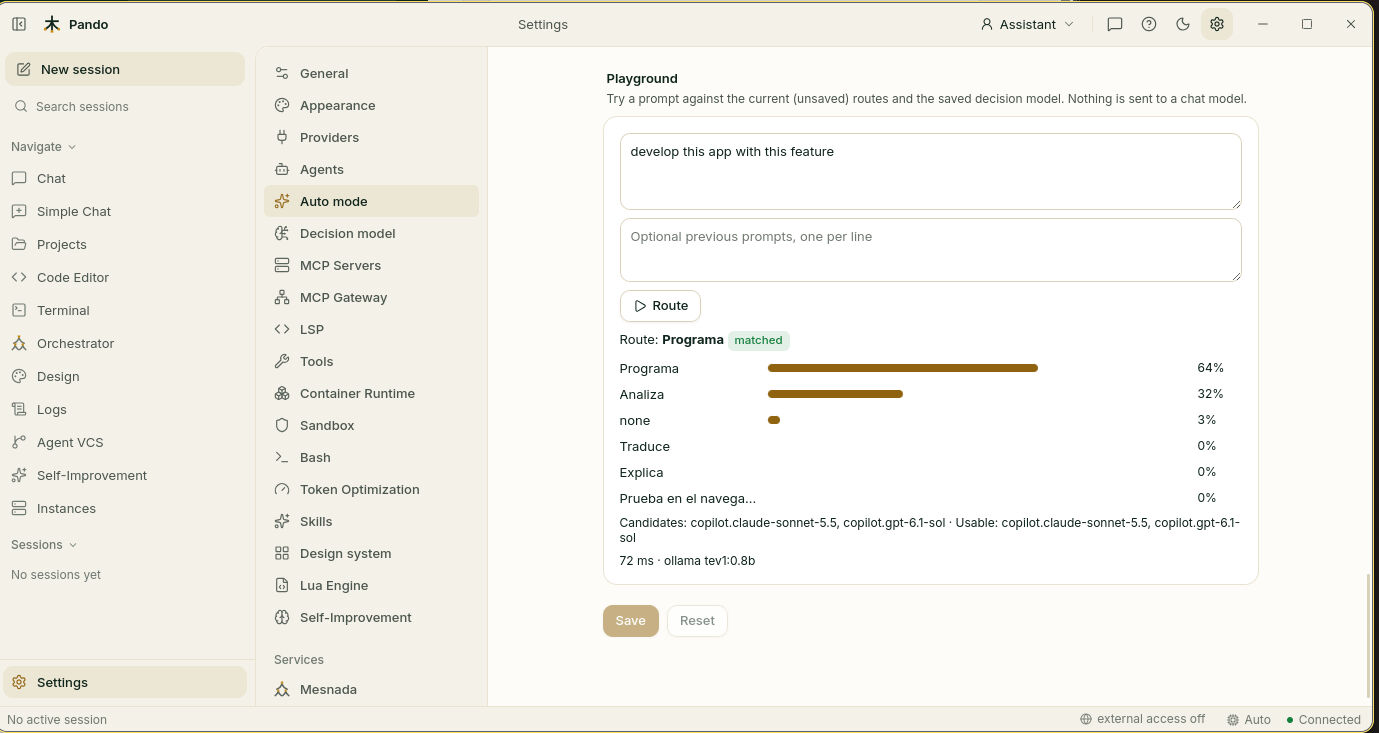
Antes de fiarte, puedes ensayar: un banco de pruebas muestra a qué puerta iría un mensaje de ejemplo, sin gastar nada.
Cuándo usarlo
Úsalo cuando tienes modelos de distinto precio y potencia y tus días mezclan preguntas rápidas con trabajo de verdad. Si solo usas un modelo, no aporta nada.
Conviene saber
- El recepcionista es un modelo diminuto que funciona en tu equipo con Ollama. Pando no lo instala por ti.
- Lo que mejor funciona son pocos tipos de trabajo y bien distintos: de tres a cinco. Si las descripciones se solapan no hay un ganador claro.
- Las respuestas cortas como «vale, sigue» no encajan en ningún tipo de trabajo y se quedan en tu modelo habitual. Suele ser lo que quieres.
- Los ayudantes lanzados por delegación conservan su propio modelo.
- Saltar de un modelo a otro en la misma conversación hace menos eficaz el descuento del proveedor por contexto repetido. Pocas rutas con modelos estables mantienen el coste bajo.
- Al elegir un modelo concreto, Auto se desactiva en esa sesión.