Configuración de Remembrances
Todas las opciones de la memoria, la base de conocimiento, el índice de código y el enriquecimiento de contexto. Para saber qué son, lee Memoria persistente y Enriquecimiento de contexto. Para configurarlo paso a paso en la Web UI, sigue la guía Enseña tu proyecto a Pando.
Todas las claves van en .pando.toml (proyecto) o ~/.pando.toml (global). En la Web UI están en Configuración > Remembrances.
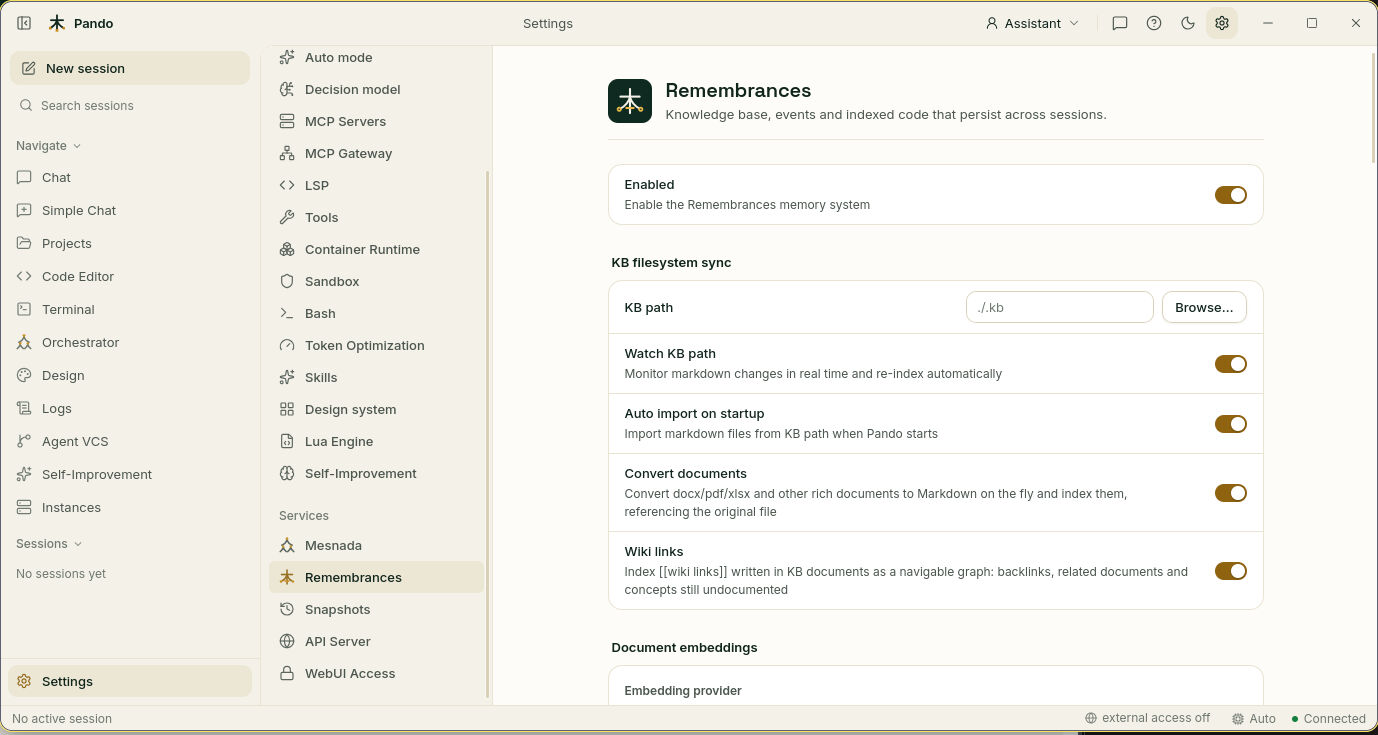
Ajustes de memoria
[Remembrances]
# Enable persistent memory system
MemoryEnabled = true

# Inject memories into context automatically
MemoryContextEnrichmentEnabled = true

# Max memories injected per prompt
MemoryContextMaxItems = 3

# Max characters for memory block (0 = unlimited)
MemoryContextMaxChars = 0

# Default TTL for memories in days (0 = 180 days)
MemoryDefaultTTLDays = 0

# Garbage collection interval
MemoryGCInterval = ''

# Auto-capture conversations as memories
MemoryAutoCapture = false

# Scopes exempt from garbage collection
MemoryPinnedScopes = []| Etiqueta en la Web UI | Clave |
|---|---|
| Memory enabled | MemoryEnabled |
| Auto-inject in context | MemoryContextEnrichmentEnabled |
| Context max items | MemoryContextMaxItems |
| Context max chars | MemoryContextMaxChars |
| Default TTL (days) | MemoryDefaultTTLDays |
| GC interval | MemoryGCInterval |
Herramientas de memoria
El agente guarda y lee memorias con tres herramientas. También quedan disponibles para otros programas cuando Pando funciona como servidor MCP (pando mcp-server).
remember guarda o actualiza una memoria:
{
  "content": "The user prefers TypeScript over JavaScript for new projects",
  "key": "user.preferred_lang",
  "scope": "user/",
  "importance": 0.8
}| Parámetro | Descripción |
|---|---|
content | El dato o la preferencia que hay que recordar |
key | Clave opcional de actualización (la misma clave sustituye a la memoria anterior) |
scope | Prefijo opcional: user/, project/, session/ |
importance | Peso para el orden de inyección, 0.0–1.0 (por defecto 0.5) |
ttl_days | Sustituye la caducidad por defecto (180 días) |
recall busca en las memorias guardadas. Los resultados se ordenan por relevancia, antigüedad y frecuencia de uso; cada consulta suma un acierto y alarga la caducidad.
{
  "query": "user language preference",
  "scope": "user/",
  "limit": 5
}
forget borra una memoria:
{
  "key": "user.preferred_lang"
}
Las memorias inyectadas llegan al prompt de sistema en un bloque <memories>, ordenadas por antigüedad, parecido semántico, frecuencia de uso e importancia. Un recolector en segundo plano borra las memorias caducadas.
Las claves descriptivas, como user/preferences/language o project/architecture/decisions, mantienen las memorias ordenadas, y los prefijos permiten búsquedas dirigidas.
Ajustes de la base de conocimiento
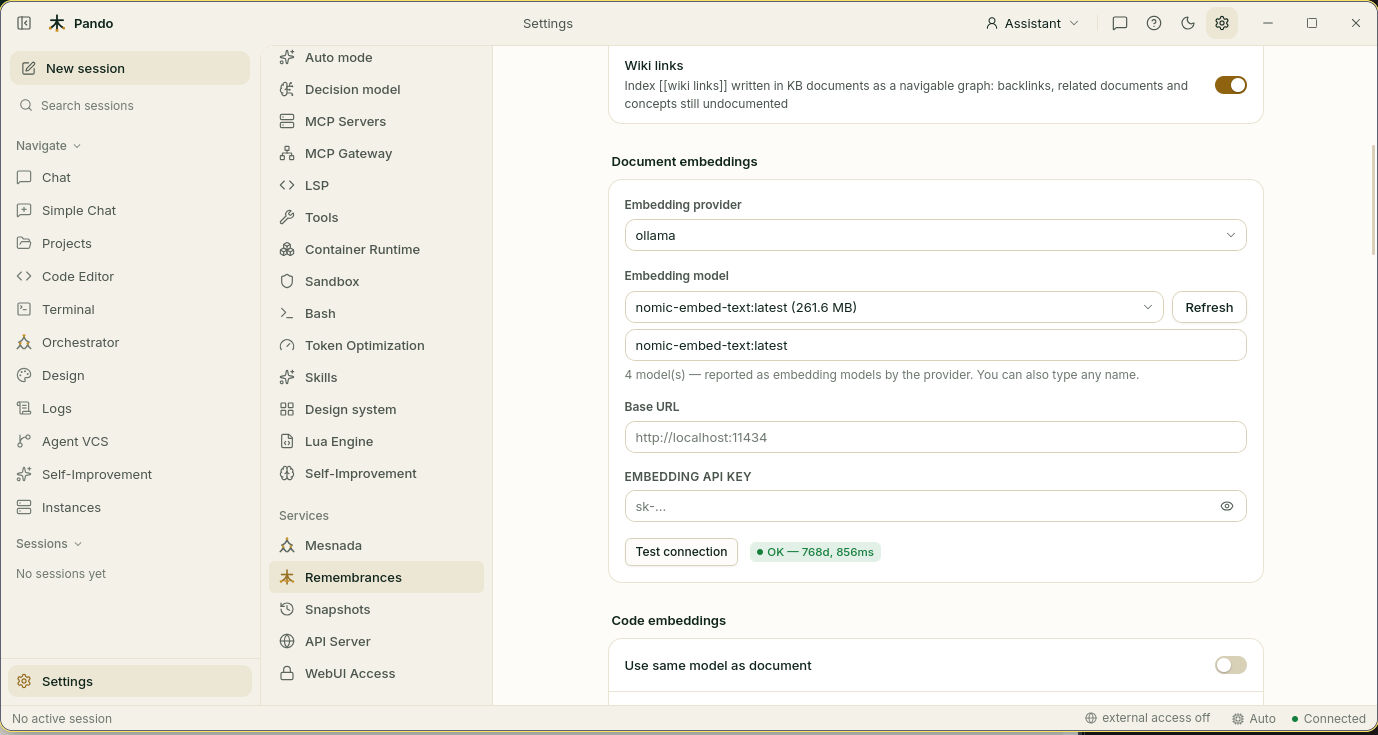
[Remembrances]
# Sync directory for KB documents
KBPath = ''

# Number of parallel sync workers (2-8)
IndexWorkers = 4

# Enable filesystem mirror for KB documents
FilesystemMirror = false
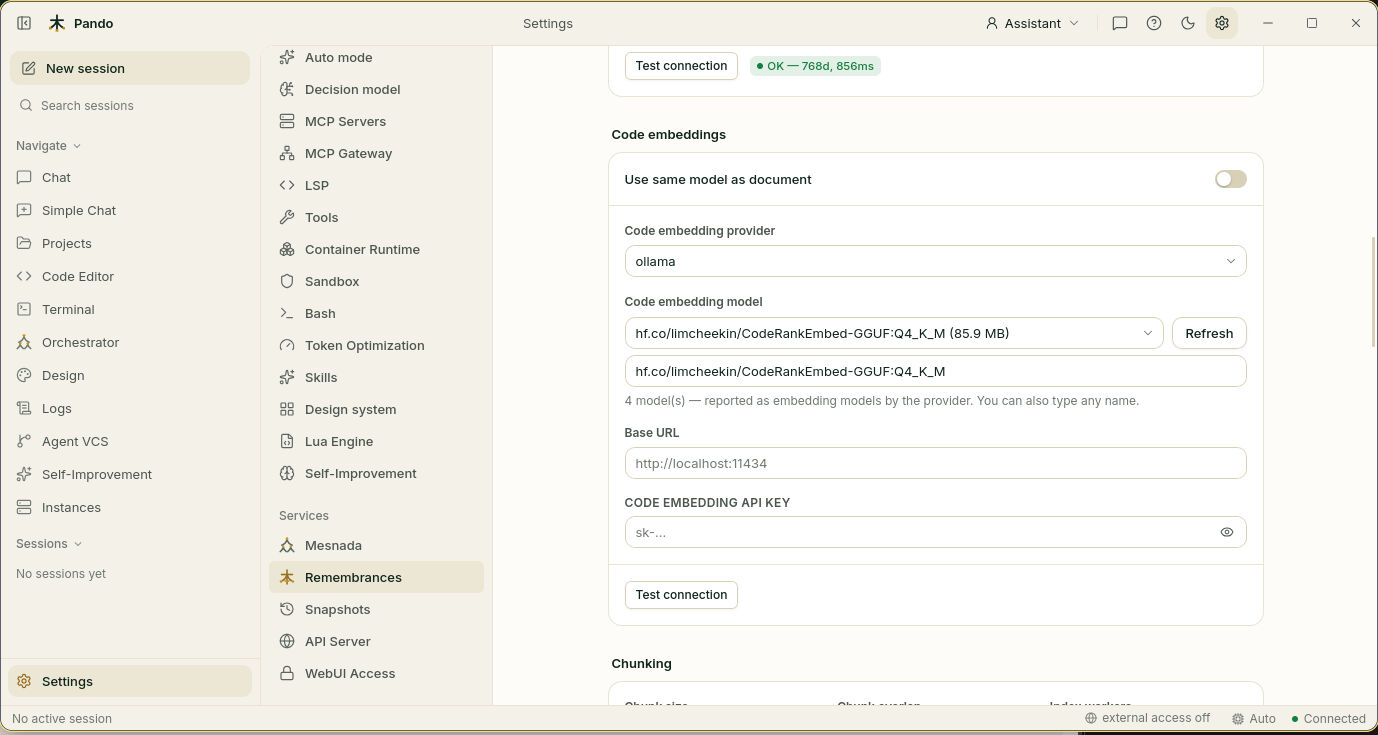
La Web UI ofrece además los interruptores Watch KB path, Auto import on startup, Convert documents y Wiki links, el proveedor, el modelo, la URL base y la clave de API de los embeddings de documentos y de código, y Chunk size, Chunk overlap e Index workers en Chunking.
Ajustes de enriquecimiento de contexto
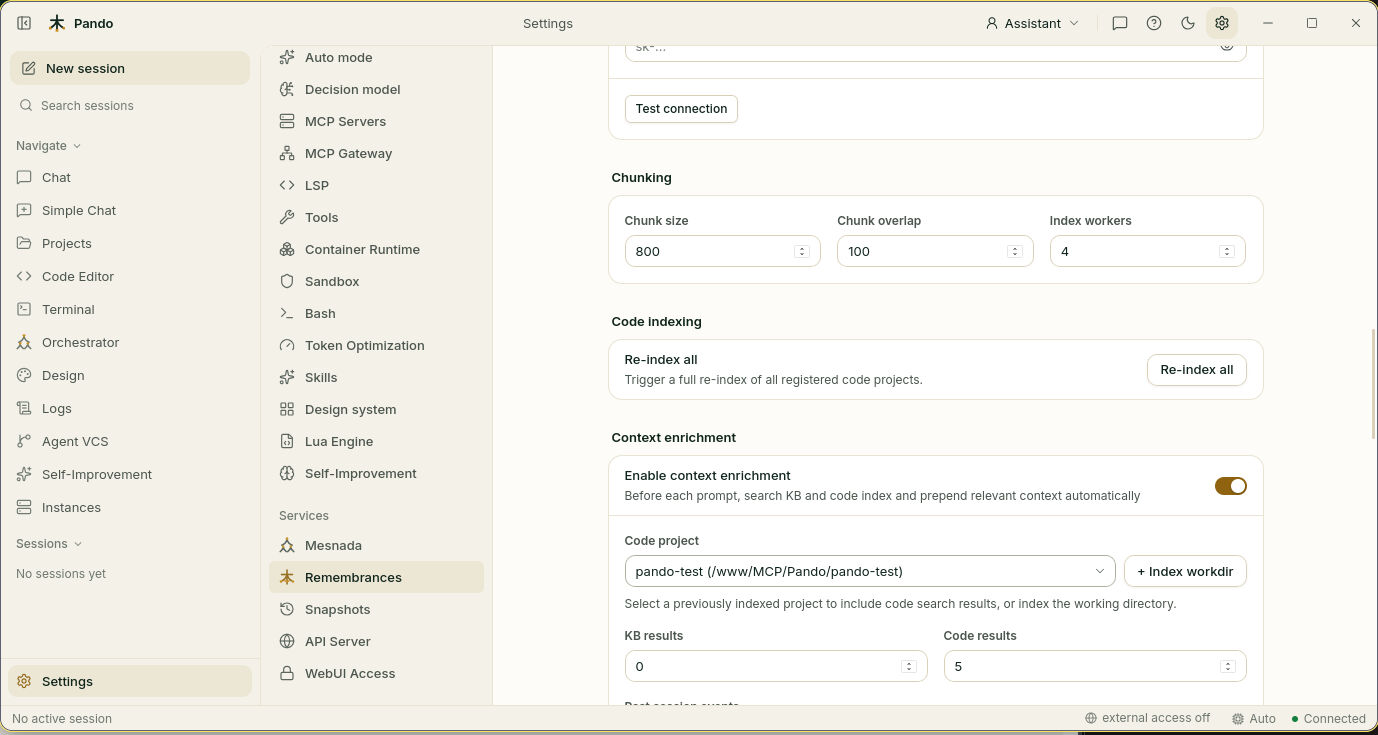
[Remembrances]
# Enable automatic context enrichment
ContextEnrichmentEnabled = false

# KB search results
ContextEnrichmentKBResults = 2
ContextEnrichmentKBMaxChars = 0

# Code search results
ContextEnrichmentCodeResults = 5
ContextEnrichmentCodeProject = 'pando'
ContextEnrichmentCodeMaxChars = 0

# Events search results
ContextEnrichmentEventsResults = 5
ContextEnrichmentEventsMaxChars = 0

# Global settings
ContextEnrichmentMinScore = 0.0
ContextEnrichmentTotalMaxChars = 0

# Planner selection
ContextEnrichmentUseAgentPlanner = false
ContextEnrichmentPlannerFallbackToCoder = false
Cómo se enriquece un mensaje
- Planificación de la consulta: un planificador analiza el mensaje del usuario.
- Búsqueda en paralelo: se busca a la vez en la base de conocimiento, el índice de código y los eventos pasados.
- Filtro por puntuación: se descartan los resultados por debajo de
ContextEnrichmentMinScore. - Inyección de contexto: lo que queda se antepone al mensaje del usuario.
Planificadores
- Planificador heurístico (por defecto): extrae palabras clave y patrones para decidir en qué fuentes buscar. Rápido y determinista.
- Planificador con LLM (
ContextEnrichmentUseAgentPlanner = true): una llamada a un modelo barato elige la estrategia de búsqueda. Más preciso, con algo más de latencia y coste de tokens.
Enriquecimiento como bucle de agente
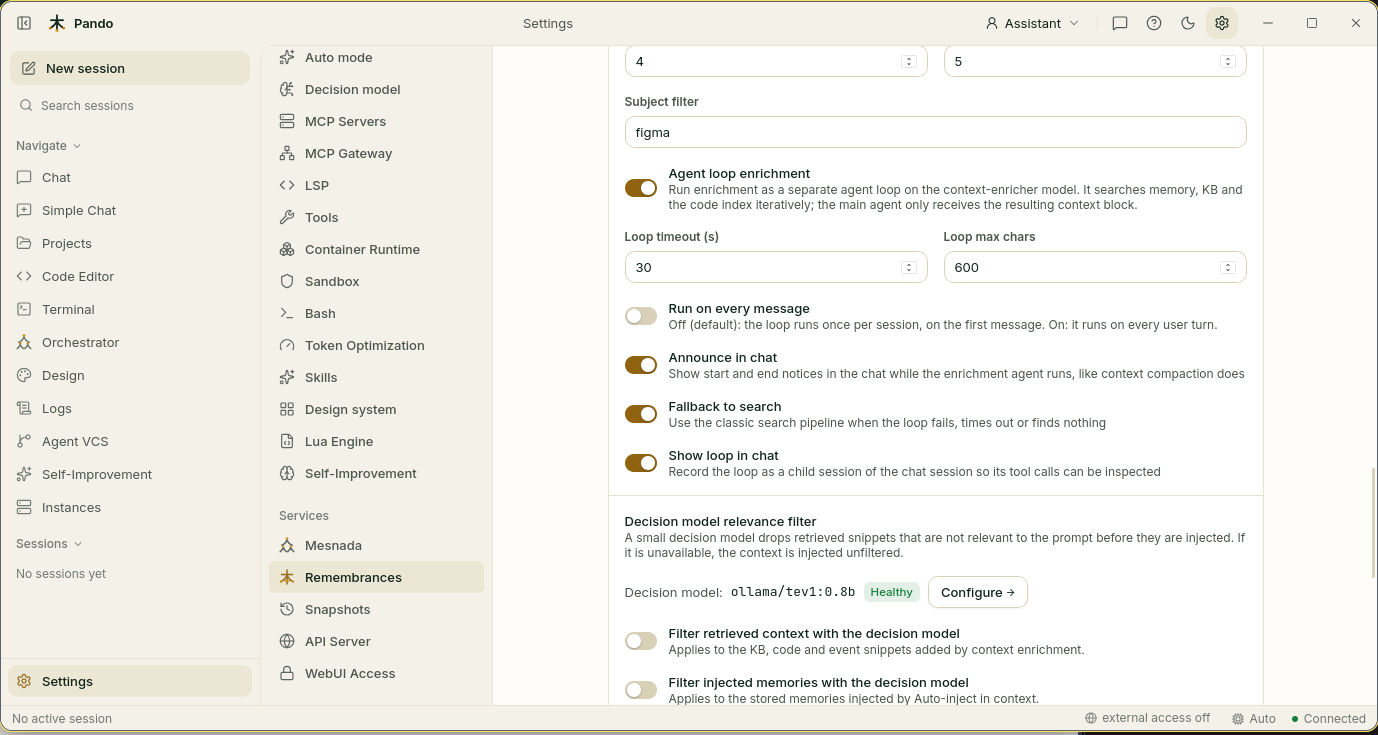
Un pequeño agente dedicado consulta la memoria, la base de conocimiento, los eventos pasados y el índice de código en varias rondas y devuelve un único bloque de contexto ya terminado. Funciona con su propio modelo:
[Agents.context-enricher]
Model = 'openrouter.some-cheap-model'

[Remembrances]
ContextEnrichmentAgentLoopEnabled        = true
ContextEnrichmentAgentLoopTimeoutSeconds = 60      # bound for one run
ContextEnrichmentAgentLoopMaxChars       = 6000    # cap on the injected context
ContextEnrichmentAgentLoopEveryMessage = false # true = every turn, not only session start- Por defecto solo se ejecuta en el primer mensaje de la sesión.
- El chat muestra
🧠 Context enrichment agent gathering project context...y después cuánto contexto añadió. - La ejecución aparece como una sesión hija del chat; su coste se suma a la sesión padre.
- Si se le agota el tiempo o no devuelve nada, se recurre a la búsqueda de un solo paso.
- El agente se prepara en segundo plano mientras arranca Pando, así que el primer mensaje no lo espera.
Interruptores de la Web UI: Agent loop enrichment, Loop timeout (s), Loop max chars, Run on every message, Announce in chat, Fallback to search, Show loop in chat. También disponible en la TUI (Remembrances → Context Enrichment).
Filtro de relevancia con el modelo de decisión
Un modelo de decisión puede descartar los fragmentos recuperados que no vienen al caso antes de inyectarlos. Si no está disponible, el contexto se inyecta sin filtrar. Campos de la Web UI: Filtrar el contexto recuperado con el modelo de decisión, Filtrar las memorias inyectadas con el modelo de decisión, Umbral de relevancia (0–1, por defecto 0.6), Máx. de candidatos, Máx. de caracteres por candidato, Permitir proveedores de decisión alojados (desactivado: solo filtran proveedores locales, así los fragmentos no salen de tu equipo).
Perfil de contexto
El recortador de contexto clasifica cada mensaje del usuario para poder saltarse las secciones del prompt que no vienen al caso:
{
  "task_type": "code|debug|refactor|explain|test|search|general",
  "relevant_tool_names": ["tool1", "tool2"],
  "skip_sections": ["capabilities/web_search"],
  "confidence": 0.85
}
Ajustes del índice de código
Qué modelo usar para el código, y por qué conviene que sea distinto del de documentos: Modelos de embeddings para código.
[Remembrances]
# Auto-index code on startup
CodeIndexAutoStart = true

# Languages to index (empty = all)
CodeIndexLanguages = []
Ajustes de descubrimiento de herramientas
Se explica en Descubrimiento de herramientas.
[ToolDiscovery]
Enabled = true
Mode = 'auto'            # 'auto', 'always', or 'off'
MaxDirectTools = 64
SearchLimit = 8
NonDeferredTools = []
DeferredSources = []
Referencia relacionada
- Navegador y demás herramientas integradas: referencia de herramientas.
- El bloque
[evaluator]: referencia de automejora.